La startup Gradium publie Phonon, une IA de synthèse vocale assez légère pour tourner sur un Raspberry Pi
La startup française Gradium vient de publier Phonon, une famille de modèles de synthèse vocale qui tournent directement sur un ordinateur portable, un smartphone, un Raspberry Pi 5 ou dans un onglet de navigateur, sans serveur ni connexion à Internet.
Le plus petit modèle de la famille, Phonon 31m, compte 31 millions de paramètres et pèse 64 Mo.
Ce petit-là ne parle qu'anglais. Pour le français, il faut passer à son grand frère Phonon 40m, décliné en un modèle par langue, dont un qui ne parle que français, et en une version multilingue qui réunit le français, l'anglais, l'allemand, l'espagnol et le portugais.
Phonon 31m est en revanche le seul de la famille sous licence Apache 2.0, qui permet de l'intégrer dans n'importe quelle appli, même commerciale.
A new frontier for on-device speech.
We're open-sourcing Phonon, a suite of TTS models under 50m parameters, setting a new standard for naturalness and accuracy across languages, with the broadest inference support to date.
Phonon-31m is available under Apache 2.0.… pic.twitter.com/Gvi7nqez9F
— Gradium (@GradiumAI) October 20, 2026
Gradium a été fondée à Paris l'an dernier par des chercheurs passés par Kyutai, le labo de recherche en IA à but non lucratif financé notamment par le groupe Iliad de Xavier Niel. La startup avait levé 70 millions de dollars dès sa sortie de l'ombre.
Deux semaines après Le Chonk de Mistral et ses 1 000 milliards de paramètres, l'IA française passe chez les poids plume : avec ses 31 millions de paramètres, le plus petit Phonon en compte plus de 30 000 fois moins.
Hors ligne, mais pas sans voix
Les voix de synthèse les plus naturelles passent en général par une API dans le cloud, facturée à l'usage : le texte part sur un serveur, qui renvoie l'audio.
Phonon fait tout sur l'appareil : le texte ne quitte jamais la machine, la voix fonctionne sans réseau et l'usage est illimité, sans facture à la clé.
Jusqu'ici, selon Gradium, la synthèse vocale embarquée obligeait à des compromis : peu de langues, des modèles trop gros pour la mémoire disponible ou une qualité trop juste pour partir en prod.
Dans une voiture, par exemple, une voix de synthèse doit tenir dans une mémoire limitée, répondre sans faire attendre le conducteur, continuer de parler dans les tunnels et les zones blanches, et maîtriser la langue de chaque pays où la voiture est vendue.
L'équipementier automobile FORVIA, né en 2022 du rachat de l'allemand HELLA par le français Faurecia, fournit sièges, éclairage et électronique embarquée à des constructeurs comme Volkswagen, Stellantis ou BMW.
Le groupe et sa filiale Appning, qui fait tourner une boutique d'applis sur l'écran central de voitures d'une quarantaine de marques, utilisent justement Phonon dans un projet de R&D mené avec Gradium.
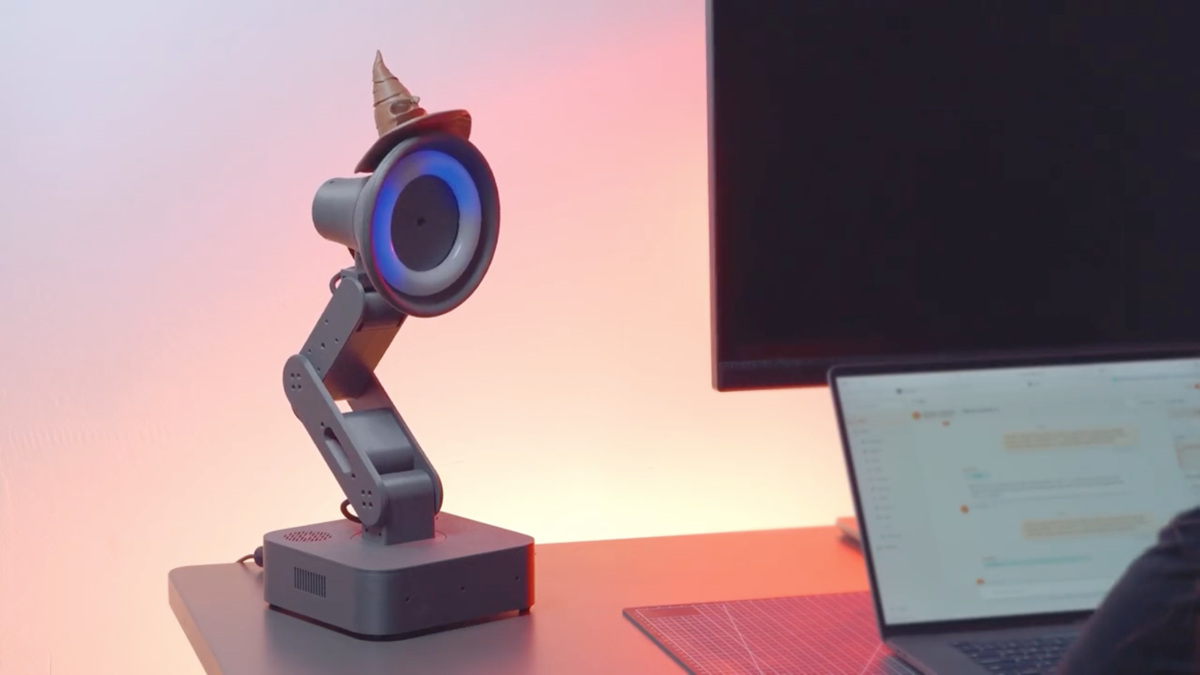
D'autres démos du lancement sont plus fun : un robot baptisé Lamp y enfile le Choixpeau magique de Harry Potter et se met à parler comme lui.
Trois modèles, deux licences, des langues à la carte
Phonon 40m pèse 74,6 Mo, et Gradium le conseille quand l'expressivité et la lecture des textes difficiles comptent le plus. Sa version multilingue réunit les cinq langues et 102 voix dans un seul modèle, de quoi servir tous les utilisateurs d'une appli avec les mêmes poids.
Phonon 40m et sa version multilingue, les seuls à parler français, sont publiés sous licence CC BY-NC : vous pouvez les télécharger et bricoler avec, mais pas les intégrer dans un produit commercial sans passer par Gradium.
Gradium entraîne aussi des modèles sur mesure avec des entreprises partenaires : plus petits, adaptés à leur vocabulaire maison ou dans d'autres langues comme le coréen, l'arabe ou le japonais.
Phonon lit en effet le texte brut, sans le convertir d'abord en phonèmes (la transcription des sons d'une langue) comme le font beaucoup de modèles de synthèse vocale. Selon Gradium, c'est justement ce qui rend l'ajout d'une nouvelle langue plus simple.
La parole est au Raspberry Pi
Sur un Raspberry Pi 5, selon les mesures de Gradium, Phonon 31m commence à parler au bout de 38 millisecondes, et chaque seconde de calcul produit 3,7 secondes de voix.
Kokoro, un modèle open source de 82 millions de paramètres très utilisé pour la synthèse vocale en local, met de son côté 7 secondes à émettre le premier son et n'arrive même pas à suivre le rythme de la parole.
Sur le processeur d'un MacBook Air M5, Phonon démarre en 7 millisecondes, contre 517 pour Kokoro.
Une partie de l'écart vient du streaming, que Kokoro ne pratique pas dans ces tests : il génère toute la phrase avant d'en lire le premier mot, alors que Phonon produit le son par tranches de 80 millisecondes et commence à parler dès la première.
Sur un iPhone 16 Pro, où il s'appuie sur le Neural Engine (la partie des puces Apple dédiée à l'IA), Phonon produit jusqu'à 22 secondes de voix par seconde de calcul. Il se passe très bien de carte graphique, mais sait en profiter quand il y en a une.
Il tourne même dans le navigateur, grâce à WebAssembly ou WebGPU : la démo de la page de Phonon génère d'ailleurs la voix directement dans votre onglet, sans le moindre serveur.
Numéros, adresses e-mail et phrases pièges
Les numéros de téléphone, les adresses e-mail et les codes postaux sont le point faible bien connu des modèles de synthèse vocale, qui les lisent souvent de travers.
Phonon fait d'abord passer le texte par une étape de normalisation, qui réécrit nombres, dates et autres codes tels qu'ils doivent être prononcés.
Pour mesurer le résultat, Gradium a constitué un jeu de test de 500 phrases par langue, tirées des cas difficiles que des développeurs lui ont envoyés : ceux sur lesquels leurs modèles actuels se plantent.
En anglais, Phonon 31m se trompe sur 1,7% des mots, deux fois moins que Kokoro (3,5%).
Lors de tests d'écoute à l'aveugle organisés par Gradium auprès de près de 1 200 auditeurs, Phonon passe aussi devant Kokoro et Magpie, le modèle de NVIDIA, et son avance serait encore plus nette dans les autres langues, français compris.
Gradium a publié son jeu de phrases pièges sur Hugging Face, de quoi refaire le match chez soi.
La voix est libre
Phonon embarque jusqu'à une centaine de voix prêtes à l'emploi, mais accepte aussi celles que vous créez avec les outils de Gradium (son Studio ou son API), gratuitement et sans limite selon la startup.
Vous pouvez y cloner une voix à partir d'un court enregistrement, avec le consentement de la personne, ou décrire en toutes lettres celle que vous voulez (Gradium cite l'exemple d'un pirate en colère).
La voix se télécharge ensuite sous forme de fichier et tourne elle aussi entièrement sur l'appareil.
Les poids sont sur Hugging Face, et le moteur qui les fait tourner est sur GitHub, avec des intégrations pour Rust, Python, Swift et JavaScript.
Le dépôt fournit aussi un serveur compatible avec l'API d'OpenAI, de quoi brancher Phonon sur du code qui appelle déjà la synthèse vocale d'OpenAI.
Ollama, LM Studio, MLX-Audio (pour les Mac à puce Apple) et Transformers, la bibliothèque de Hugging Face, intègrent déjà Phonon.
Pour les plus pressés, la page de Phonon fournit même un prompt à coller directement dans votre agent de code.
Ce prompt envoie l'agent sur le dépôt GitHub de Phonon et lui demande d'en lire le README avant toute chose et de s'y fier plutôt qu'à ses suppositions (un conseil qui vaut aussi pour les humains 👀), puis d'installer Phonon et de lui faire dire "Hello world" : on ne déroge pas aux grands classiques !
Pour essayer Phonon sans rien installer, direction sa page officielle, qui le fait parler directement dans votre navigateur.
Pour l'installer, les instructions (Homebrew, pip, npm ou Cargo, selon votre langage) sont dans le README de son dépôt GitHub, et les modèles se téléchargent sur Hugging Face.
À propos de l'auteur

Nicolas Lecointre
Fondateur des Joies du Code, je suis l'actualité et la culture des développeurs depuis 2012. Ancien développeur, je me consacre aujourd'hui entièrement au média.
Offres d'emploi
 Senior Développeur Front-End - Team Poker (H/F)Winamax · Paris · CDI · 60-65k €
 Expert CERT - investigation et réponse H/F/NOVHcloud · Bordeaux / Nantes +5 · Hybride · CDI
 Senior Software EngineerSkello · Paris · Hybride · CDI · 55-70k €
 Gestionnaire ACSSI F/HCommissariat au Numérique de Défense - CND · Creil · CDD (3 ans)
À lire également
Tech Show Paris 2026 : DevOps Live et quatre autres salons pour un seul badge gratuit, les 18 et 19 novembre
Les 18 et 19 novembre 2026, Tech Show Paris souffle sa 10ème bougie à Paris Expo Porte de Versailles, avec la recette qui fait sa marque : un seul badge...
Articles similaires
OpenAI affirme que GPT-6.1 Sol migre du COBOL vers Java ou Rust avec 98 % de réussite
Meta lance Muse Spark et fait ses adieux à Llama (et à l'open source)
Mozilla lance cq, le Stack Overflow des agents IA
OpenAI acquiert Astral, le créateur de uv et Ruff
OpenAI affirme que GPT-6.1 Sol migre du COBOL vers Java ou Rust avec 98 % de réussite
Plus de contenu
Quand je quitte le bureau le vendredi
Quand je veux présenter mon appli à un ami et qu'elle plante dès son lancement
Quand le binôme me montre les "améliorations" qu'il a apportées à mon code
ON M'A DIT QU'IL FALLAIT LIVRER AU PLUS VITE.
Quand un utilisateur me partage son écran et que je vois qu'il utilise encore IE
Quand je reçois des merge conflicts après une journée intense de travail
Quand je colle mon erreur à l'IA et qu'elle me recommande avec aplomb une librairie qui n'existe pas
Quand je push sans tester
Quand je quitte le bureau le vendredi
Quand je veux présenter mon appli à un ami et qu'elle plante dès son lancement
Quand le binôme me montre les "améliorations" qu'il a apportées à mon code
ON M'A DIT QU'IL FALLAIT LIVRER AU PLUS VITE.
Quand un utilisateur me partage son écran et que je vois qu'il utilise encore IE